Ein Agent, der Produktionscode schreibt, braucht ein Gate, das er nicht selbst öffnen kann
Ich lasse Claude Workflows schreiben und auf meine n8n-Instanz ausrollen. Keine Vorschläge, die ich von Hand reinkopiere. Echte workflow.json, hochgeladen über eine Pipeline, laufend gegen echte Kalender, echte Postfächer, echte Tabellen.
Wovor ich Angst hatte, war nie schlechter Code. Schlechter Code scheitert laut, meistens beim ersten Lauf, und dann behebst du ihn.
Wovor ich Angst hatte, ist plausibler Code. Ein Workflow, der richtig aussieht, sich richtig liest, einen flüchtigen Blick übersteht und dann still dieselbe Mail zweimal verschickt. Oder eine Zeile schreibt und Erfolg meldet, ohne je zu prüfen, ob die Zeile existiert. Oder eine unerwartete API-Antwort als „nichts zu tun" behandelt und jeden einzelnen Morgen grün wird, während er überhaupt nichts tut.
Und hier ist der Teil, den niemand ins Architekturdiagramm zeichnet: Nach dem fünften generierten Workflow liest du nicht mehr sorgfältig. Die Schwachstelle sitzt nicht im Modell. Sie sitzt beim Menschen, der das Modell eigentlich erwischen soll und sich langweilt.
Also habe ich aufgehört, mich selbst als Gate einzuplanen.
Ein Vertrag, kein Prompt
Ein Prompt ist ein Ratschlag. Der Agent folgt ihm vielleicht, meistens tut er es, und wann nicht, erfährst du nur, indem du jede Zeile liest.
Ein Vertrag ist die Menge an Regeln, die etwas anderes prüfen kann. Meiner ist kurz:
- Code-Nodes werfen nur fünf Fehlercodes:
INVALID_INPUT,INVALID_AI_RESPONSE,TIMEOUT,UPSTREAM_UNAVAILABLE,CONFIG_ERROR. Nie einen rohen Fehlerstring, nie etwas, das aus den Daten abgeleitet ist, die den Fehler ausgelöst haben. - Jeder erfolgreiche Pfad endet in einem
Verify Outcome-Node, der beweist, dass die Nebenwirkung eingetreten ist. - Nodes, die schreiben (Mail, Tabellen, CRM, jeder POST, PUT oder DELETE), bekommen nie
retryOnFail. Lesende dürfen. - Jeder HTTP-Node hat ein explizites Timeout.
- Secrets existieren nur als Credential-Referenzen. Die Workflow-Datei enthält eine ID und einen Namen, nie ein Token.
Ein Linter prüft die prüfbare Hälfte, bevor irgendetwas hochgeladen wird: die Retry- und Timeout-Regeln, acht Secret-Muster, die Execution-Einstellungen (erfolgreiche Läufe werden nicht gespeichert, fehlgeschlagene zur Diagnose behalten) und dass jeder Verify-Node existiert und sich zum Scheitern zwingen lässt. Das ist wichtig, aber es ist der Boden, nicht das Gate. Ein Linter sagt dir, dass die Form zulässig ist. Er kann dir nicht sagen, dass der Workflow jemanden zweimal anruft.
Trennen nach Fähigkeit, nicht nach Anweisung
„Du darfst nicht deployen" im System-Prompt ist ein Wunsch.
Das Setup hat zwei Claude-Skills, die orchestrieren (Delivery und Kunden-Onboarding), und drei Subagents mit engen Aufgaben: einen Builder, einen Reviewer und einen Ops-Analysten. Der Builder schreibt workflow.json, eine README und eine ops.json in einen Ordner und hört auf. Der Reviewer liest und führt den Linter aus.
Als ich den ersten Entwurf dieses Posts geschrieben habe, stand im nächsten Satz, der Reviewer sei read-only „wegen seiner Tool-Liste, nicht weil ich nett gefragt habe". Vor der Veröffentlichung habe ich nachgesehen. Beide Agents hatten Bash in ihrer Tool-Liste. Eine Shell kann jede Datei schreiben und jedes CLI aufrufen, auch das, das deployt. Die Trennung, die ich als strukturell beschrieben hatte, lebte komplett im Prompt, und genau dagegen argumentiert dieser Abschnitt.
Die Tool-Liste allein kann das nicht beheben, weil sie nur ganze Tools kennt: Bash heißt jeder Befehl, Write heißt jede Datei. Also ist die Grenze in einen Hook gewandert, der vor jedem Tool-Aufruf dieser beiden Agents läuft und im Zweifel blockiert (fail closed):
# .claude/agents/workflow-reviewer.md
tools: Read, Grep, Glob, Bash
disallowedTools: Write, Edit, NotebookEdit
hooks:
  PreToolUse:
    - matcher: "Bash"
      hooks:
        - type: command
          command: python3 "$CLAUDE_PROJECT_DIR/operations/tooling/agent_guard.py" reviewer
Der Reviewer darf genau einen Befehl ausführen, den Linter mit --no-write, gegen einen Workflow-Ordner. Kein Verketten, keine Pipes, keine Substitution, kein ... Der Builder hat überhaupt keine Shell und darf nur workflow.json, README.md und ops.json innerhalb eines Workflow-Ordners schreiben, nachdem Symlinks aufgelöst wurden. Alles, was der Guard nicht parsen kann, wird blockiert. Der Guard hat eigene Tests, die größtenteils aus Versuchen bestehen, ihn zu umgehen. Und ich habe es live geprüft: Jeder Agent sollte jede seiner Regeln einmal brechen. Jeder Versuch außerhalb der Grenze wurde gestoppt, entweder weil das Werkzeug für diesen Agent gar nicht existiert, oder durch den Guard. Einer war nicht einmal geplant: Beim Auftrag, einen Befehl zu verketten, hat der Reviewer von sich aus zuerst ein cd ... && vor den Lint gesetzt. Ebenfalls blockiert.
Der Ops-Analyst und der Onboarding-Skill arbeiten weiterhin nur mit Anweisungen. Sie kamen nicht zuerst dran, weil sie nicht auf dem Weg in die Produktion liegen; sie sind die nächsten.
Und dann die Regel, auf der das Ganze ruht:
Der Reviewer reviewt nie einen Workflow, den er in derselben Session selbst gebaut hat.
Ein Agent, der seinen eigenen Output reviewt, ist eine Rechtschreibprüfung, kein Reviewer. Er glaubt die Sache schon. Er findet Tippfehler und übersieht die doppelte Nebenwirkung, weil die Begründung, die das Duplikat erzeugt hat, noch in seinem Kontext liegt und wie eine gute Begründung aussieht.
Der Reviewer bekommt den Ordner, den Kundenkontext, die Trap-Liste und keine Erinnerung daran, irgendetwas davon geschrieben zu haben. Er liefert eine feste Form zurück, die zugleich der Nachweis ist, den ein Mensch liest, bevor irgendetwas aktiviert wird:
VERDICT: PASS | FAIL
FINDINGS:
- <BLOCKER|MAJOR|MINOR> <node or file>: <finding>
UNPROVEN: <assumptions only a real test run can settle>
SUMMARY: <one line for the acceptance log>
BLOCKER ist ein Datenschutzleck, eine doppelte oder falsche Nebenwirkung, ein Secret in der Datei oder ein Workflow, der sich nicht aktivieren lässt. MAJOR ist ein falsches fachliches Ergebnis in einem realistischen Fall, eine fehlende Fehlerantwort oder ein Verify-Node, der nichts beweist. Beides lässt den Build scheitern, und der Fix geht zurück durch ein frisches Review. Das Urteil wird so geloggt, wie es zurückkam, ob es mir gefällt oder nicht.
Die Reihenfolge der Gates
- Plan. Instrumentieren, linten, einen Diff ausgeben, aus dem die Werte entfernt sind. Nur Struktur, damit ein Diff nie leaken kann, was er vergleicht.
- Commit und CI. Pre-commit führt gitleaks, den Linter und die Tests aus. CI führt sie erneut aus, plus gitleaks über die gesamte History. Grün oder Stopp.
- Apply. Der Workflow wird inaktiv hochgeladen, und die vorherige Definition wird vorher gesichert. Das ist der Draft Pull Request dieses Setups: Das Artefakt existiert im Zielsystem und kann noch nichts tun.
- Review. Der unabhängige Agent, wie oben beschrieben.
- Testlauf, Fehler erwartet. Ein Flag zwingt den Verify-Node zu werfen. Der Fehler muss mit dem erwarteten Code, am erwarteten Node, verlinkt mit der Execution auf dem Dashboard ankommen.
- Testlauf, Erfolg erwartet. Echte Nebenwirkungen passieren. Ein echter Mail-Entwurf, eine echte Zeile. Ich sage vorher an, was entstehen wird.
- Activate. Wird verweigert, solange das Review und beide Testläufe nicht nach dem letzten Apply geloggt wurden.
Schritt 5 vor Schritt 6 ist Absicht, und es ist der Schritt, den die meisten Pipelines auslassen. Der Fehlerpfad ist der, den niemand durchspielt. Ist deine Fehlerbehandlung kaputt, findest du das standardmäßig während eines Incidents heraus, wenn genau das kaputt ist, was dir eigentlich Bescheid sagen sollte. Einen Fehler mit Absicht zu erzwingen, während nichts kaputt ist, ist billig.
Es gibt Notausgänge, und so zu tun, als gäbe es keine, wäre derselbe Fehler wie bei der Tool-Liste: apply akzeptiert --allow-dirty und --skip-ci-check, activate akzeptiert --force. Jeder davon wird neben dem Schritt, den er übersprungen hat, ins Abnahme-Log geschrieben. Bisher wurde keiner benutzt.
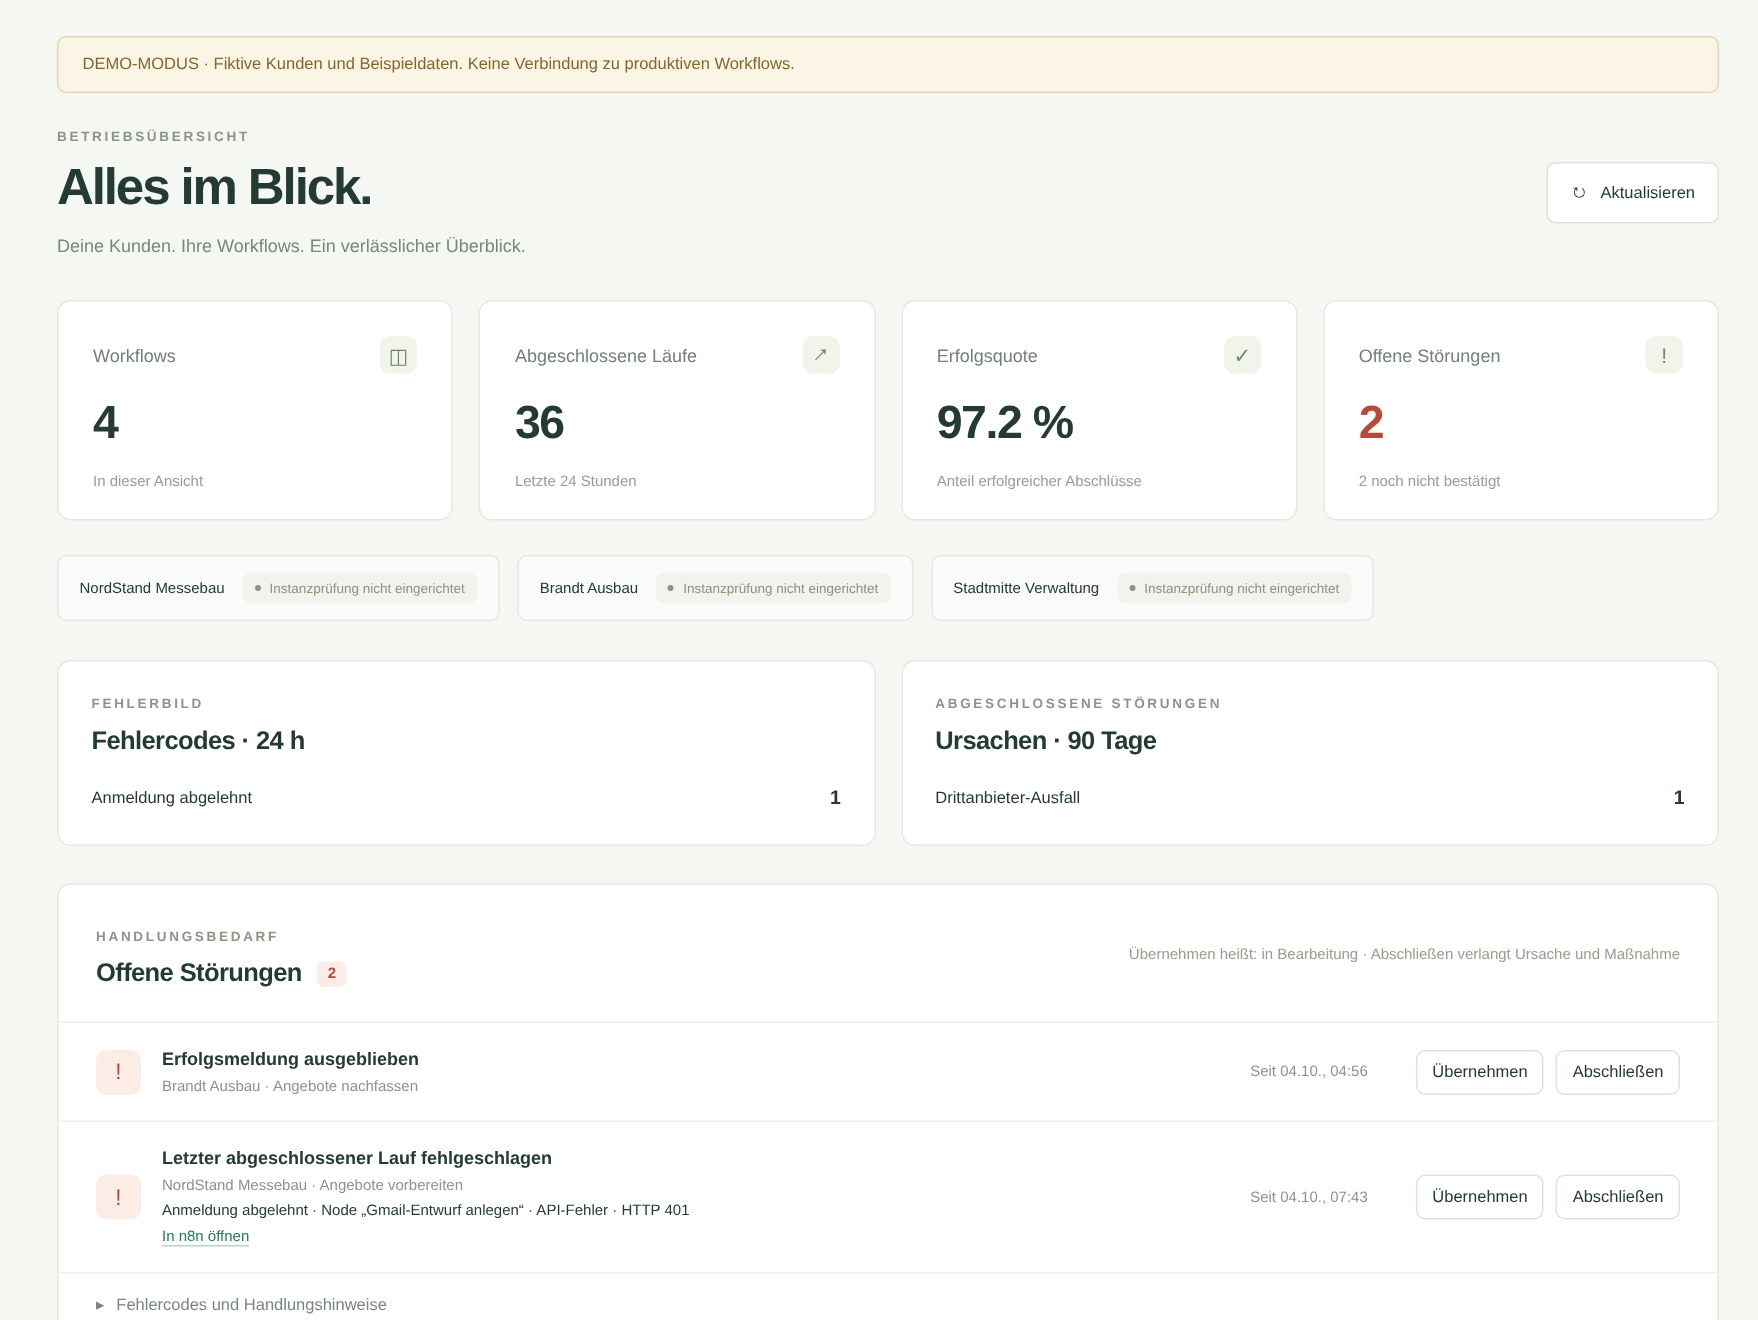
Das Operations-Dashboard im Demo-Modus, mit fiktiven Kunden. Entscheidend ist die Form des zweiten Incidents: Katalogcode, Node, Ursache und ein Link zur Execution. Der erzwungene Fehler in Schritt 5 muss genau das erzeugen.
„Kein Fehler" ist kein Ergebnis
Die häufigste Art, wie Automatisierung dich anlügt: Der Lauf ist durch, keine Exception wurde geworfen, das Dashboard ist grün, und nichts ist passiert.
Deshalb endet jeder erfolgreiche Pfad in einem Node, dessen einzige Aufgabe es ist, das fachliche Ergebnis zu prüfen. Nicht „es gab kein Fehlerfeld". Die eigentliche Sache: Eine ID kam zurück, eine Zeile wurde geschrieben, die Anzahl stimmt.
Das Detail, das das Ganze echt macht, ist zu wissen, was jeder Node garantiert zurückgibt. Gmail und Calendar liefern eine echte ID, also ist es fair, eine zu verlangen. Der Google-Sheets-Append-Node in der Version, die ich nutze, gibt größtenteils den gemappten Input zurück statt der API-Antwort, eine Prüfung auf eine ID wäre dort also eine Lüge, die sich als Check verkleidet. Der Verify-Node hält fest, welches Feld als Nachweis gedient hat. Im echten Testlauf des Sprachassistenten kam dieses Feld leer zurück, also ist der Sheets-Pfad heute nur dadurch bewiesen, dass der Node bei einem API-Fehler nicht wirft, und durch nichts weiter. Das steht auf der offenen Liste, nicht in der Erfolgsspalte.
Der „nichts zu tun"-Pfad bekommt einen eigenen Verify-Node, der null zurückgibt. Das klingt nach Bürokratie und ist es nicht. „Nichts zu tun" ist genau der Ort, an dem sich stille Fehler verstecken: Eine unbekannte Antwortform wird zur leeren Liste, eine leere Liste wird zu „heute keine Arbeit", und „heute keine Arbeit" ist von Erfolg nicht zu unterscheiden, so lange du wegschauen willst. Deshalb wirft eine unbekannte Form. Falsch zu liegen lässt sich beheben. Still falsch zu liegen nicht.
Aus Review-Reibung wird Testdesign
Zwei Dinge fließen zurück ins System statt in mein Gedächtnis.
Das erste ist eine Datei mit Fallen, die auf die harte Tour gefunden wurden. Jedes Mal, wenn sich herausstellt, dass eine Node-Option nicht tut, was sie verspricht, kommt sie da rein, und beide Agents lesen sie, bevor sie anfangen. Der deutlichste Fall: ein Datumsfenster, gesetzt über die eigenen Zeitoptionen des Calendar-Nodes, die der Node still ignoriert hat. Ein Testlauf des Morgenbriefings las 35 Termine von Montag bis Freitag, während der Workflow, und jeder, der ihn las, annahm, er schaue auf heute. Die Regel, die daraus entstand, ist jetzt Teil des Vertrags: Fachliche Filter leben im Code mit expliziter Zeitzone, nie in einer Node-Option, deren Wirkung unbewiesen ist.
Das zweite ist die UNPROVEN-Liste des Reviewers: die Annahmen, die sich durch noch so viel Lesen nicht klären lassen, nur durch einen echten Lauf. Diese Liste wird in den Erfolgstest mitgenommen und gegen die tatsächliche Execution geprüft. Richtiger Tag, richtige Einträge, erwartete Felder, sonst zurück zum Build-Schritt. Technisch grün reicht nicht.
Was das Log sagt, als ich zum ersten Mal gezählt habe
Jedes Gate schreibt pro Workflow eine Zeile in ein Abnahme-Log. Ich hatte diese Zeilen wochenlang gesammelt und nie zusammengezählt. Für diesen Post habe ich es getan, für die vier Workflows, die zwischen dem 16. und 22. September durch die Pipeline gelaufen sind.
| Workflows, die ihr erstes Review bestanden haben | 0 von 4 |
| Geloggte Review-Urteile | 12 (5 bestanden, 7 durchgefallen) |
| Aktivierte Workflows | 2 von 4 |
| Von einem Gate zurückgehalten | 2 (ein durchgefallenes Review, ein gescheiterter Erfolgstest) |
| CI-Läufe im Repo, 16. bis 23. September | 23 von 25 grün |
| Benutzte Notausgänge | 0 |
Die erste Zeile ist die interessante. Jedes erste Review ist durchgefallen, und zwar nicht am Stil. Die Findings waren genau die Klasse plausiblen Codes vom Anfang dieses Posts: Abruffehler, die zu einem stillen „nichts zu tun"-Erfolg wurden, ein Deduplizierungs-Marker, der geschrieben wurde, bevor die Mail tatsächlich verschickt war, ein Debounce, den zwei Trigger im selben Zeitfenster beide passieren konnten, was in diesem Workflow zwei echte Telefonanrufe bedeutet hätte, und ein Webhook-Pfad, der dem Anrufer, der in der Leitung wartete, nie geantwortet hat.
Das Morgenbriefing ist der, den ich aus dem Bauch heraus ausgeliefert hätte. Er kam durchs Review, nachdem seine Findings behoben waren, sein erzwungener Fehler kam korrekt an, und dann sah der Erfolgstest innerhalb des Zeitfensters kein Erfolgsereignis. Er ist immer noch inaktiv. Das ist die Pipeline, die funktioniert, und das überzeugt mich mehr als jede der grünen Zeilen.
Das Zählen hat außerdem zwei Probleme in der Messung selbst gefunden.
Zwei Reviews fehlen. Zwei Workflows erreichen ein Review, das im Log „4th pass" heißt, mit nur zwei Einträgen davor. Das Review lief; niemand hat es geloggt. Loggen ist ein Befehl, an den der Orchestrator denken muss, was bedeutet, dass die Nacharbeitsquote, die ich gerade berichtet habe, eine Untergrenze ist.
Zwei grüne Fehlertests haben nichts bewiesen. Der Erzwungener-Fehler-Test des Sprachassistenten ist dreimal bestanden. Zweimal trug das Ereignis, das ihn erfüllt hat, UPSTREAM_UNAVAILABLE, nicht das INVALID_INPUT, das der erzwungene Fehler wirft. Der Test-Runner wartete auf irgendein Fehlerereignis und akzeptierte das erste. Ein Fehlertest, der bei jedem Fehler besteht, testet nicht den Fehlerpfad; er testet, dass irgendetwas schiefgegangen ist. Jetzt prüft er Code und Node, standardmäßig INVALID_INPUT an einem Verify-Node, pro Workflow überschreibbar, wo der Fehler weiter hinten im Pfad gemeldet wird. Zwei der sieben grünen Fehlertests im Log würden heute durchfallen.
Keins von beiden hätte ich durch Lesen des Codes gefunden. Beides war innerhalb von Minuten sichtbar, nachdem ich die Zeilen nebeneinandergelegt hatte.
Was ich immer noch nicht gemessen habe
Das ist der ehrliche Teil, und es ist der Teil, den ich lesen wollen würde, wenn jemand anderes das hier geschrieben hätte.
Das sind Zahlen, kein Benchmark. Vier Workflows, eine Woche, ein Operator. Sie beschreiben, was passiert ist, und sie haben zwei Defekte gefunden. Sie können mir nicht sagen, ob eine Änderung am Vertrag oder an den Anweisungen des Builders etwas verbessert hat.
Mein Reviewer ist nicht wirklich unabhängig. Builder und Reviewer sind dasselbe Modell. Was sich unterscheidet, sind Kontext und, jetzt tatsächlich durchgesetzt, Tool-Rechte. Das ist echte Trennung, und die Tabelle zeigt, dass sie echte Dinge findet. Aber ich kenne die tatsächliche True-Positive-Rate des Reviewers nicht. Der Erzwungener-Fehler-Test beweist den Fehlerpfad des Workflows. Er beweist nichts darüber, ob der Reviewer einen Defekt gefunden hätte, den ich nicht platziert habe.
Das fehlende Stück ist ein Benchmark aus echter Historie. Ein fester Satz vergangener Briefings mit bekannt guten Ergebnissen, inklusive derer, die im ersten Review durchgefallen sind, damit sich eine Änderung bewerten lässt, statt darüber zu streiten. Die interessanten Fehler sind selten und kontextabhängig, also würden zehn synthetische Briefings die einfache Hälfte messen und mir über die schwere Hälfte eine bequeme Lüge erzählen. Die sieben durchgefallenen Urteile oben sind die ersten echten Einträge für diesen Satz. Ihre Findings sagen schon, was ein gutes Review finden sollte.
Was ich habe, ist ein Satz Gates, die das System sicher machen, ohne zu beweisen, wie gut es ist. Ich halte das für die richtige Reihenfolge: Ein ungemessenes sicheres System ist überlebbar, ein gemessenes unsicheres nicht. Aber die erste Zählung hat sich bereits doppelt bezahlt gemacht, und das ist ein starkes Argument dafür, es kontinuierlich zu tun statt für einen Blogpost.
Die Form, ohne den n8n-Teil
Tausch Workflows gegen Pull Requests, Terraform-Plans oder Datenbankmigrationen, und das Muster hält:
- ein Vertrag, den der Agent erfüllen muss, so geschrieben, dass eine Maschine das meiste davon prüfen kann
- ein Reviewer, der strukturell nicht der Builder sein kann, durchgesetzt dort, wo der Tool-Aufruf passiert, und nicht im Prompt
- eine inaktive Landezone, damit das Artefakt existiert, bevor es handeln kann
- ein erzwungener Fehler vor dem echten Lauf, der den konkreten Fehler prüft, weil der Fehlerpfad der ist, den niemand testet
- ein letzter Schritt, der die Nebenwirkung beweist, statt nur das Fehlen eines Fehlers festzustellen
- ein Log jeder Gate-Entscheidung, und jemand, der es tatsächlich auszählt
Nichts davon macht den Agenten besser. Es macht die Fehler des Agenten billig und sichtbar, und das ist ein anderes Ziel und, für alles, was Produktion berührt, das nützlichere.
Das vollständige Setup, inklusive dessen, was die Beispiel-Workflows tun und wo sie zu kurz greifen, ist als Projekt beschrieben.
Zum Umfang, damit hier nichts größer klingt, als es ist: Das läuft auf meiner eigenen selbst gehosteten n8n-Instanz bei Hetzner, mit einem Operations-Dashboard, das ich dafür gebaut habe und das in Docker Compose hinter nginx läuft. Die Pipeline ist von Grund auf mandantenfähig ausgelegt und wird derzeit nur mit meinen eigenen Workflows und Demo-Tenants betrieben.