Agent Delivery Pipeline
Abgesicherte Auslieferung für von Agents generierte n8n-Workflows. Ein KI-Agent schreibt den Workflow; die Pipeline entscheidet, ob er jemals laufen darf.
Läuft auf meiner eigenen selbst gehosteten n8n-Instanz. Von Grund auf mandantenfähig ausgelegt, derzeit nur mit meinen eigenen Workflows und Demo-Tenants betrieben. Das Repository ist privat, weil es Kunden-Scaffolding enthält; der Artikel Ein Agent, der Produktionscode schreibt, braucht ein Gate, das er nicht selbst öffnen kann geht das Design und die erste Messung durch.
Was es ist
Eine Delivery-Pipeline für Workflows, die ein KI-Agent geschrieben hat. Der
Agent erzeugt eine n8n-workflow.json. Bevor diese Datei einen echten Kalender,
ein Postfach oder eine Tabelle anfassen darf, muss sie einen Vertrag, ein
unabhängiges Review, einen erzwungenen Fehler und einen echten Erfolgslauf
bestehen, und jede dieser Entscheidungen landet in einem Abnahme-Log neben dem
Workflow.
Zwei Claude-Skills orchestrieren, drei Subagents erledigen enge Aufgaben. Die Spalte, auf die es ankommt, ist die letzte: wo die Grenze tatsächlich durchgesetzt wird.
| Rolle | Art | Darf | Darf nicht | Durchgesetzt durch |
|---|---|---|---|---|
workflow-delivery | Skill | den zwölfstufigen Ablauf und das Deploy-Tool ausführen | einen Schritt überspringen, ein Urteil ändern | die Vorbedingungen des Deploy-Tools |
client-onboarding | Skill | Tenant-Isolation, Error Handler und Ingest-Token anlegen | Business-Workflows anfassen | nur Anweisungen |
workflow-builder | Agent | workflow.json, README.md, ops.json in einem Workflow-Ordner schreiben | irgendeinen Shell-Befehl ausführen, deployen, woanders schreiben | Tool-Liste ohne Bash + PreToolUse-Hook bei jedem Schreibzugriff |
workflow-reviewer | Agent | lesen, greppen, den Linter mit --no-write ausführen | irgendetwas schreiben, irgendeinen anderen Befehl ausführen | Write/Edit gesperrt + PreToolUse-Hook bei jedem Shell-Aufruf |
ops-analyst | Agent | das Dashboard lesen, Incidents kategorisieren, die Monatsauswertung entwerfen | irgendetwas ändern | nur Anweisungen: er hat noch eine Shell |
Bis zu diesem Monat stand auch in den Zeilen für Builder und Reviewer „nur
Anweisungen": Beide Agents hatten eine Shell, und die Grenzen lebten im Prompt.
Sie kamen zuerst dran, weil sie auf dem Weg in die Produktion liegen. Die zwei
Zeilen, in denen es noch steht, sind die nächsten. Der Hook, der die Anweisungen
ersetzt hat, blockiert im Zweifel (fail closed) und wird größtenteils mit
Versuchen getestet, ihn zu umgehen: Verkettung, Pipes, Command Substitution,
.., Symlinks aus dem Repository heraus, fehlerhafte Eingaben.
Die Gates
build → plan → commit → CI → apply (inactive) → independent review
      → test run, expect error → test run, expect success → activate
- Plan instrumentiert den Workflow, lintet ihn und gibt einen Diff aus, in dem jeder Wert durch einen Digest ersetzt ist, damit der Diff nie leaken kann, was er vergleicht.
- Commit und CI. Pre-commit führt gitleaks, den Linter und die Tests aus; CI wiederholt sie und scannt die gesamte History.
- Apply verweigert einen nicht committeten Ordner oder rote CI, sichert die live laufende Definition und lädt dann inaktiv hoch: Das Artefakt existiert im Zielsystem, bevor es handeln kann.
- Review durch den Reviewer-Agent, der nie einen Workflow reviewt, den er in
derselben Session gebaut hat. Sein Output hat eine feste Form: Urteil,
Findings nach Schweregrad, die Annahmen, die nur ein echter Lauf beweisen
kann, eine Zusammenfassungszeile für das Log. Ein
BLOCKER- oderMAJOR-Finding schickt den Workflow zurück zum Build-Schritt und verlangt ein frisches Review. - Testlauf, Fehler erwartet setzt ein Flag, das den Verify-Node werfen lässt. Der Lauf besteht nur, wenn das Dashboard den erwarteten Katalogcode am erwarteten Node empfängt. Bis zu diesem Monat hat er jedes Fehlerereignis akzeptiert; das Auszählen des Logs hat gezeigt, warum das nicht gut genug war.
- Testlauf, Erfolg erwartet erzeugt echte Nebenwirkungen, vorher angekündigt, und wird gegen die Liste unbewiesener Annahmen des Reviewers geprüft.
- Activate verweigert, solange das Review und beide Testläufe nicht nach dem letzten Apply geloggt wurden.
Die Notausgänge (--allow-dirty, --skip-ci-check, --force) existieren und
werden bei Benutzung ins Abnahme-Log geschrieben. In den bisherigen Logs wurden
sie nie benutzt.
Der Vertrag
Durchgesetzt teils vom Linter, teils vom Reviewer:
- nur fünf Fehlercodes, nie rohe Meldungen, nie Daten in einer Meldung
- jeder erfolgreiche Pfad endet in einem
Verify Outcome-Node, der die echte Nebenwirkung prüft (zurückgegebene IDs, geschriebene Zeilen, Anzahlen) und sich dabei nur auf Felder verlässt, die der Node garantiert zurückgibt - der „nichts zu tun"-Pfad hat einen eigenen Verify-Node, der null zurückgibt, damit ein stilles Durchfallen nicht als Erfolg durchgehen kann
- schreibende Nodes machen nie Retries; lesende dürfen
- jeder HTTP-Node hat ein Timeout
- Secrets existieren nur als Credential-Referenzen, nie in der Workflow-Datei
- Duplikatschutz: Gate unmittelbar vor der Nebenwirkung geprüft, Marker unmittelbar danach gesetzt
- fachliche Filter leben im Code mit expliziter Zeitzone, nicht in Node-Optionen, deren Wirkung unbewiesen ist
Die letzte Regel stammt aus einer Fallen-Datei, die beide Agents lesen, bevor sie anfangen. Jede Node-Option, die sich als nicht das tuend herausgestellt hat, was sie verspricht, steht dort drin, mit dem Commit oder der Execution, die es bewiesen hat.
Erste Messung
Vier Workflows sind zwischen dem 16. und 22. September 2026 durch die Pipeline gelaufen. Ausgezählt aus ihren Abnahme-Logs:
| Erstes Review bestanden | 0 von 4 |
| Geloggte Review-Urteile | 12 (5 bestanden, 7 durchgefallen) |
| Aktiviert | 2 von 4 |
| Von einem Gate zurückgehalten | 2 |
| CI-Läufe, 16. bis 23. September | 23 von 25 grün |
| Benutzte Notausgänge | 0 |
Jedes Durchfallen im ersten Review war ein echter Defekt der plausiblen Sorte: Abruffehler, die zu einem stillen No-op-Erfolg wurden, ein Dedup-Marker, der vor dem Versand geschrieben wurde, ein Debounce, den zwei Trigger gleichzeitig passieren konnten, ein Webhook-Pfad, der nie geantwortet hat. Die Zählung hat außerdem zwei Defekte in der Messung selbst gefunden: zwei Reviews, die liefen, aber nie geloggt wurden, und zwei „bestandene" Fehlertests, die den falschen Fehler akzeptiert hatten. Beides ist behoben oder im Artikel festgehalten. Vier Workflows sind eine Baseline, kein Benchmark.
Betrieb
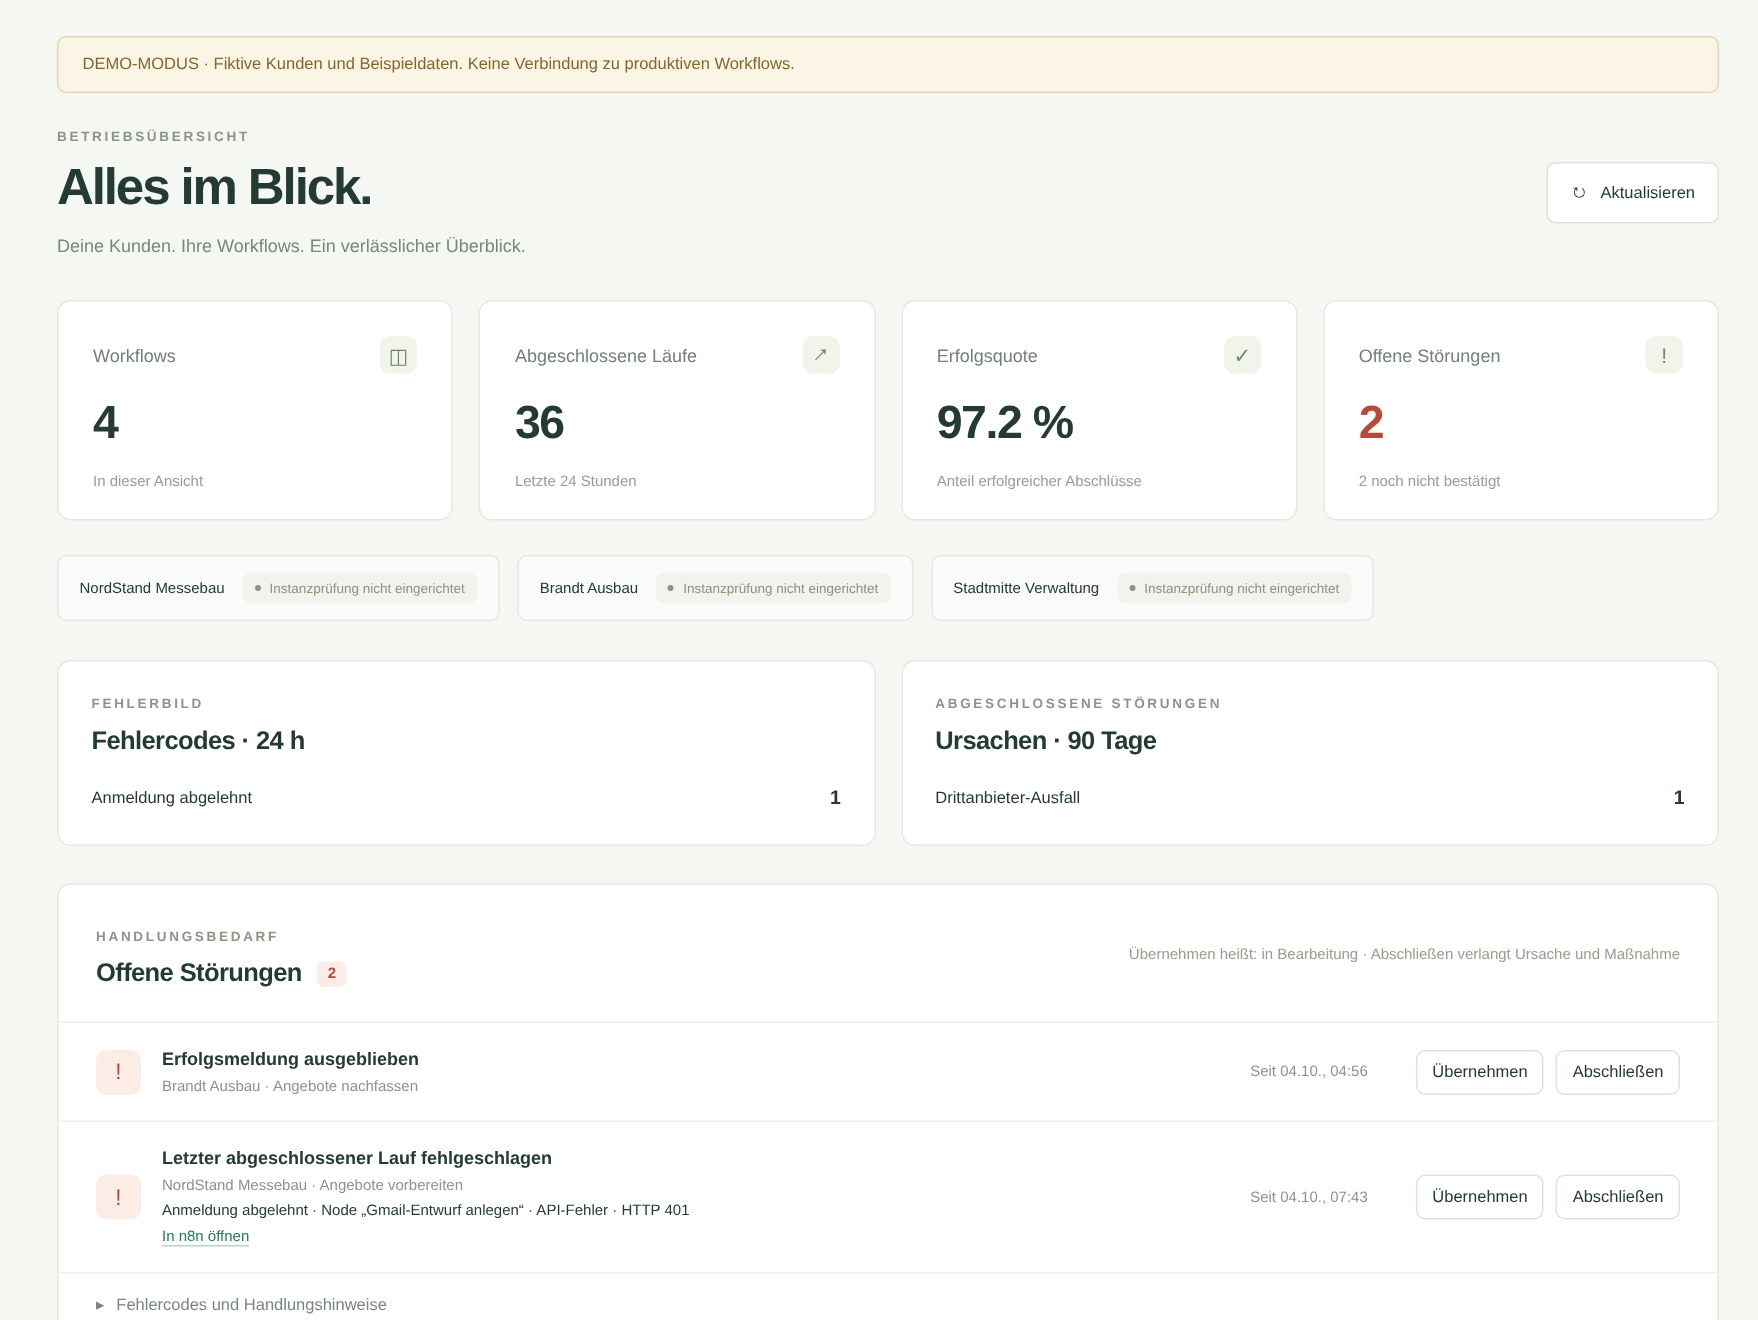
Selbst gehostetes n8n bei Hetzner. Das Operations-Dashboard läuft in Docker Compose hinter nginx, in einem read-only Container ohne Capabilities, gebunden an localhost. Es empfängt Start-, Erfolgs- und Fehlerereignisse pro Workflow und Execution: nur technische IDs, Status, Zeitangaben, Node-Namen und Katalogcodes, nie Nachrichteninhalte oder Tokens. Fehlgeschlagene Läufe und ausgebliebene Erfolgsmeldungen werden zu Incidents. Um einen zu schließen, braucht es eine Ursache (Credential abgelaufen, Ausfall beim Anbieter, Konfigurationsfehler, Datenqualität beim Kunden, Bug im Workflow, Kunde hat den Prozess geändert, unbekannt) und eine Maßnahme. Die Übersicht zeigt die Fehlercodes der letzten 24 Stunden und die Ursachen der in den letzten 90 Tagen geschlossenen Incidents. Ein Selbsttest prüft den Monitoring-Pfad alle fünf Minuten.
Tenants sind getrennt durch Tag, Namenspräfix, einen eigenen Error Handler und ein eigenes Ingest-Token. Das Onboarding verifiziert die Trennung, indem es prüft, dass ein falsches Token und der Workflow eines anderen Tenants beide abgewiesen werden.
Beispiel-Workflows
Voice Tool Hub (aktiv). Der Rückkanal eines Telefonassistenten. Er darf vier
Tools aufrufen und keine anderen, und er validiert jedes Argument, bevor
irgendetwas geschrieben wird. Nichts, was er erzeugt, ist endgültig: Mail wird
zu einem Gmail-Entwurf und nie zu einem Versand, eine Rechnung wird zu einer
Entwurfszeile in einer Tabelle, die wie die API des Buchhaltungssystems
aufgebaut ist, Notizen werden zu Zeilen, und Termine werden zu Kalendereinträgen
mit der Markierung [per Telefon]. Jede Tool-Anfrage wird beantwortet, auch auf
jedem Fehlerpfad. Schickt der Assistent zwei Tool-Aufrufe in einer Nachricht,
wird nur der erste verarbeitet, deshalb verbietet der Prompt des Assistenten
selbst parallele Aufrufe. Der Nachbereitungszweig nach dem Anruf hat kein
solches Netz, mit Absicht, weil dann niemand mehr in der Leitung wartet. Das
Kalender-Tool wurde noch in keinem echten Lauf durchgespielt, und der Nachweis
für die beiden Tabellen-Tools ist schwächer als für Mail und Kalender, weil der
Sheets-Node keine ID zum Prüfen zurückgibt.
Morgenbriefing (zurückgehalten). Startet einen Anruf, wenn ich ins Auto steige, und liest die Termine des Tages und die wichtigsten ungelesenen Mails vor. Es schickt Absender, Betreff, einen Ausschnitt von 200 Zeichen und Terminorte an das Sprachmodell und den Voice-Anbieter, ist also kein reiner Metadaten-Workflow, und die README sagt das auch. Ein Debounce erlaubt einen Anruf pro Tag; eine zweite Prüfung fragt unmittelbar vor dem Wählen die eigene API des Telefonieanbieters, weil lokaler Zustand zu spät geschrieben wird, um einen parallelen Trigger zu stoppen. Ein Fenster von einer bis drei Sekunden bleibt, dokumentiert als akzeptiertes Risiko. Es hat das Review nach mehreren Runden von Findings bestanden, sein erzwungener Fehler kam korrekt an, und sein Erfolgstest nicht. Es ist immer noch inaktiv, und das ist die Pipeline, die ihre Arbeit macht. Selbst ein grüner Lauf würde nur beweisen, dass der Anbieter den Anruf angenommen hat, nicht dass das Telefon geklingelt hat, und auch das sagt die README.
CVE-Digest (aktiv). Eine tägliche Mail mit neuen Schwachstellen für den Stack, den ich betreibe, sortiert zuerst nach bekannter Ausnutzung, dann nach Schweregrad und Exploit-Wahrscheinlichkeit. Sein erstes Review hat gefunden, dass gesehene IDs gespeichert wurden, bevor die Mail verschickt war, und dass ein Ausfall beim Anbieter wie ein ruhiger Tag ausgesehen hätte.
Bekannte Lücken
- Builder und Reviewer sind dasselbe Modell. Die Trennung besteht aus Kontext und durchgesetzten Tool-Rechten, nicht aus einem anderen System.
- Das Review-Logging hängt davon ab, dass der Orchestrator den Log-Befehl aufruft; zwei Reviews liefen und wurden nie geloggt.
- Es gibt keinen Benchmark historischer Briefings, gegen den sich Änderungen bewerten lassen. Die durchgefallenen ersten Reviews sind die ersten Einträge für einen.
- Der Erfolgsnachweis der Tabellen-Tools ist „der Node hat nicht geworfen", keine zurückgegebene ID.
Umfang
Läuft auf meiner eigenen Instanz. Von Grund auf mandantenfähig ausgelegt, derzeit nur mit meinen eigenen Workflows und Demo-Tenants betrieben. Kein zahlender Kunde läuft darauf, und der Delivery-Prozess verlangt einen unterschriebenen Auftragsverarbeitungsvertrag, bevor einer das kann.