Mein Server bezahlt einen KI-Sprachanruf, den er nie hört
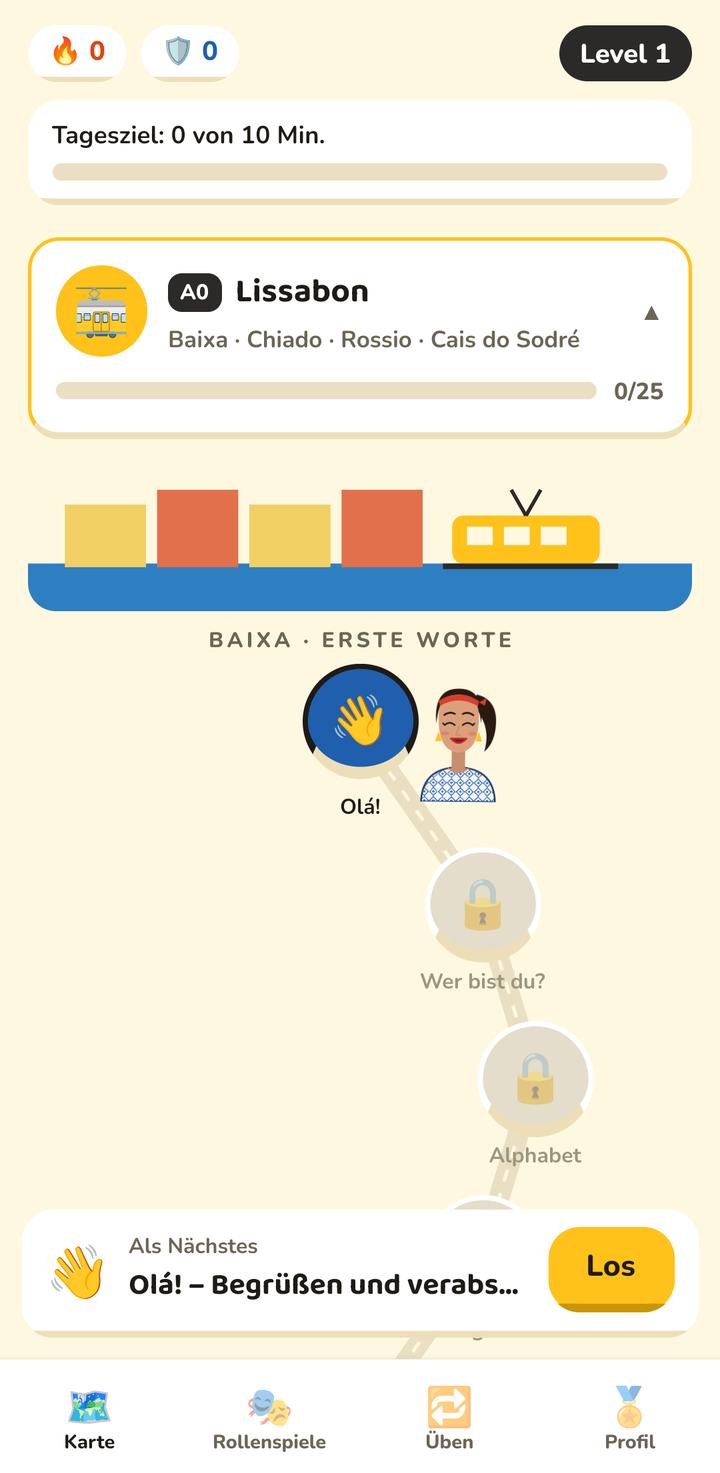
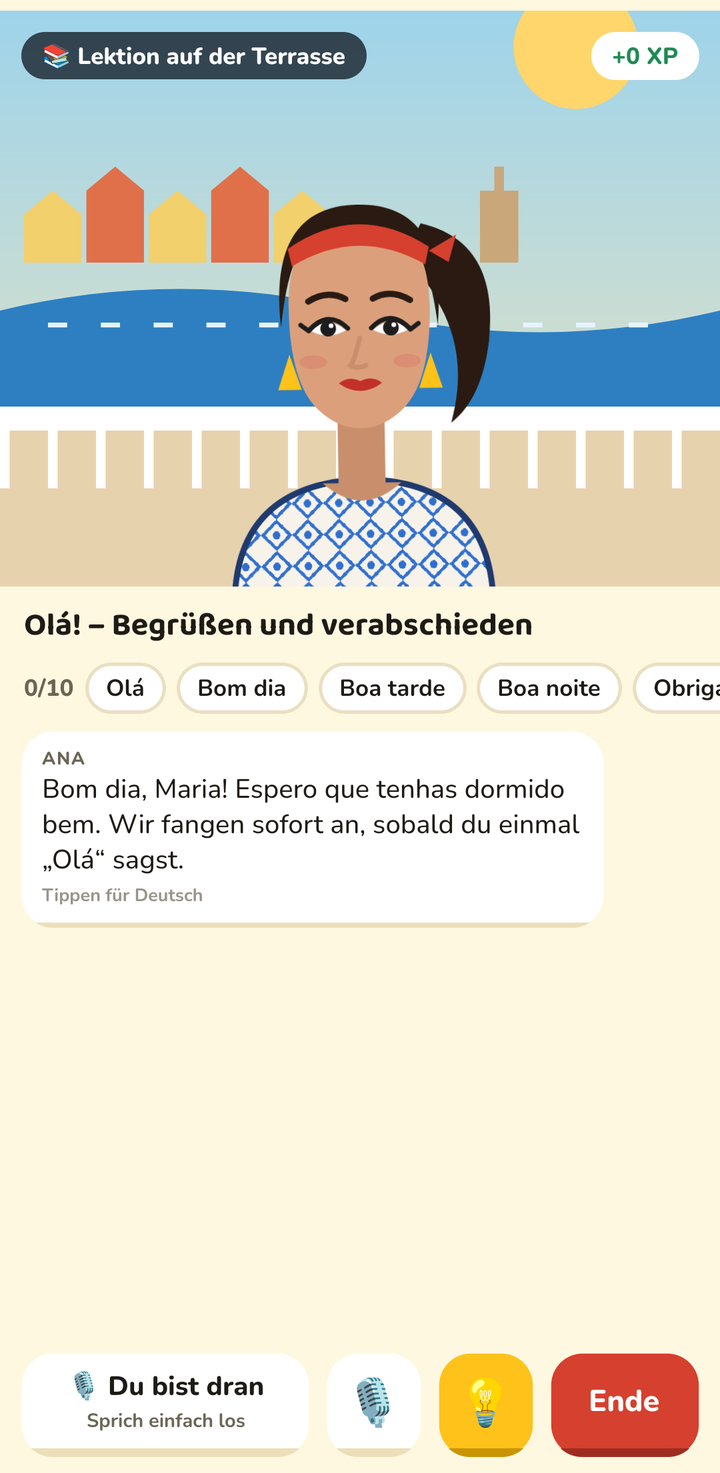
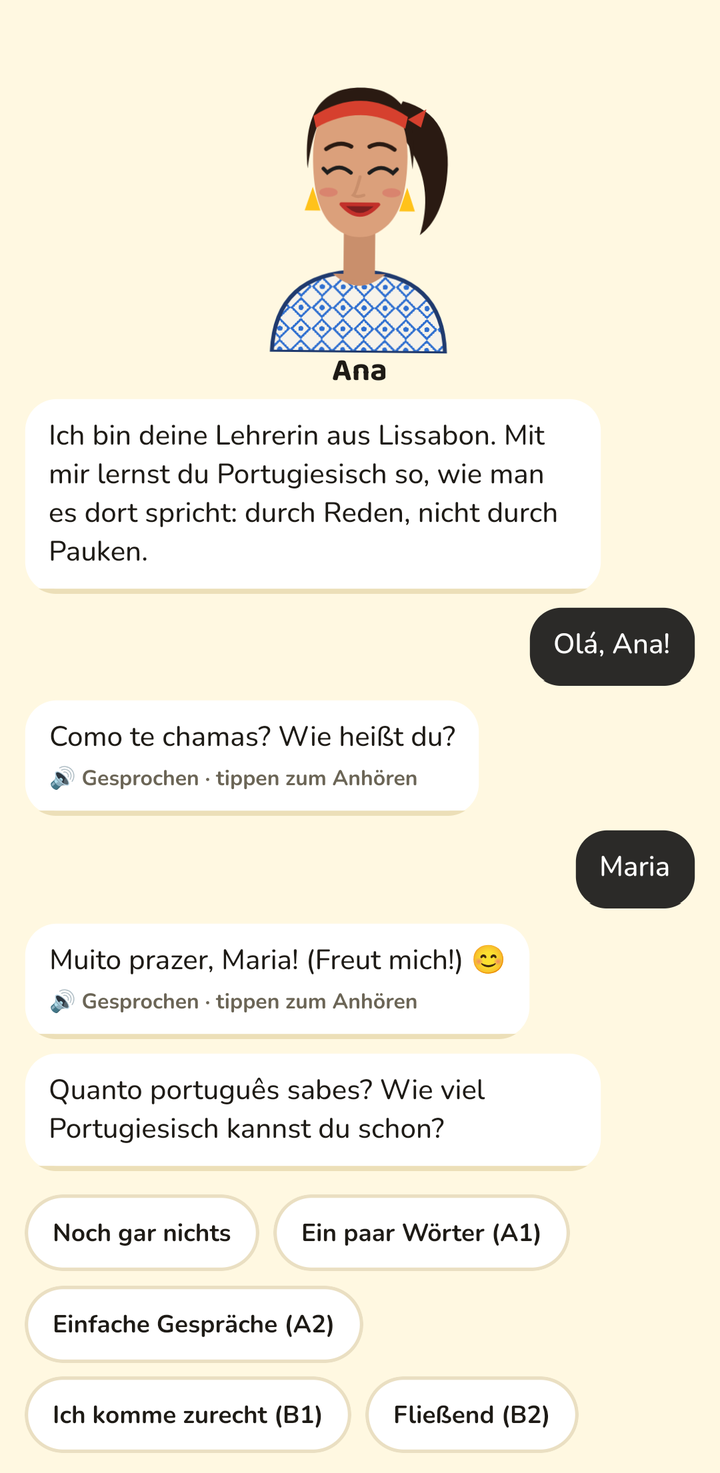
Falar ist ein Sprechtrainer für europäisches Portugiesisch. Du sprichst mit Ana, einer Lehrerin aus Lissabon, und sie antwortet laut, korrigiert dich und merkt sich, welche Fehler du immer wieder machst. Seit dem 1. Oktober ist die App im internen Test bei Google Play.
Die Architekturentscheidung, die alles andere bestimmt: Das Handy spricht direkt mit OpenAIs Realtime API, über WebRTC. Mein Backend legt den Anruf an und hält den API-Schlüssel, aber das Audio läuft nie hindurch. So bleibt die Antwortzeit bei etwa einer Sekunde, und nur so habe ich es geschafft, dass das Modell tatsächlich hört, wie jemand ein Wort ausspricht, statt eine Mitschrift davon zu lesen.
Es heißt aber auch: Der teuerste Teil des Systems läuft auf einem Gerät, das ich nicht kontrolliere, über eine Verbindung, die ich nicht sehe, auf meine Rechnung.
Was eine manipulierte App tun könnte
Der Datenkanal eines Realtime-Anrufs ist nicht schreibgeschützt. Der Client kann darüber Ereignisse senden, und die API lässt sich nicht anweisen, sie abzulehnen. Eine gepatchte APK (und eine APK lässt sich leicht patchen) könnte:
| Ziel | Wie | Ohne Wächter |
|---|---|---|
| Ana in einen Allzweck-Assistenten verwandeln | session.update mit neuen Anweisungen | mein Schlüssel, beliebiger Prompt |
| Das Antwortlimit entfernen oder Tools ergänzen | session.update | unbegrenzte Antworten, neue Fähigkeiten |
| Mitten im Gespräch einen eigenen Prompt einschleusen | conversation.item.create als system oder getippter user | dasselbe, Nachricht für Nachricht |
| Antworten mit eigenen Einstellungen bestellen | response.create mit anderen Limits oder außerhalb des Gesprächs | die Limits der Session gelten nicht |
| Weniger bezahlen | meinem Backend einen kürzeren Anruf melden | das Budget glaubt der App |
Für nichts davon braucht es den API-Schlüssel. Die App hält nur ein Token für mein Backend. Die Gefahr ist, dass der Anruf, mit dem sie verbunden ist, bereits bezahlt wird.
Die Form der Abwehr

Drei Regeln, geordnet danach, wie sehr ich ihnen vertraue.
Der Server bestimmt die Konfiguration. Die App schickt genau eine Sache: ihr WebRTC-SDP-Angebot. Das Backend baut die Session selbst (Anweisungen aus dem Lektionsplan, Stimme, Antwortlimit, Sprecherwechsel-Erkennung) und legt den Anruf mit dem eigenen Schlüssel bei OpenAI an. Die App bekommt die SDP-Antwort zurück und sonst nichts. Sogar Anas Begrüßung schickt der Server, damit die App nie in den Prompt schreibt, nicht einmal legitim. Das wird für die nächste Regel wichtig.
Der Server beobachtet den Anruf von der Seite. OpenAI erlaubt dem Backend eine zweite Verbindung, eine WebSocket zum selben Anruf über dessen ID. Sie sieht nicht die Rohnachrichten des Clients, aber jedes Server-Ereignis des Anrufs, auch die, die Aktionen des Clients auslösen: eine geänderte Session, ein neuer Eintrag im Gespräch, eine startende Antwort. Jeder Anruf bekommt einen Wächter-Thread auf dieser Verbindung, und der Wächter legt bei allem auf, was meine App nie tut.
Der Server führt die Uhr. Abgerechnet wird nach dem Startzeitpunkt des Anrufs und dem Ende, das der Wächter oder das Auflegen festhält. Was die App meldet, wird nie verwendet.
Was der Wächter prüft
Weil die App nur sprechen soll, ist alles, was sie schreibt, per Definition fremd. Das hält die Regeln kurz:
if kind == "session.updated":
    # Only follows a session.update, and neither we nor our app send one.
    break  # hang up

if kind in ("conversation.item.added", "conversation.item.created") and foreign_item(item, ...):
    # system/developer messages other than our greeting, any typed user text,
    # assistant text we did not write ourselves
    break

if kind == "response.created" and foreign_response(response, answer_limit):
    break
Für die dritte Prüfung brauchte es einen Live-Test. Ich musste wissen, wie eine vom Client bestellte Antwort vom Sideband aus aussieht, verglichen mit einer, die die Sprecherwechsel-Erkennung des Servers gestartet hat. Am 2. Oktober habe ich beides ausgelöst und die response.created-Ereignisse verglichen. Drei Felder verraten es:
def foreign_response(response: dict, answer_limit: int) -> bool:
    """Our answers always use the session's limit and audio, in the conversation."""
    return (
        response.get("conversation_id") is None          # out-of-band answer
        or response.get("max_output_tokens") != answer_limit
        or response.get("output_modalities") != ["audio"]
    )
Und eine Regel für den Wächter selbst: Ein unbewachter Anruf darf nicht laufen. Wenn das Sideband sich nicht verbinden kann oder aus einem anderen Grund abbricht als dem Ende des Anrufs, legt der Wächter auf:
except ConnectionClosed:
    return  # the app hung up: nothing left to guard
except Exception:
    logger.exception("Realtime guard failed, hanging up: call=%s", call_id)
hang_up(call_id)
Der Wächter setzt außerdem das Zeitlimit durch (30 Minuten pro Anruf plus eine Minute Kulanz) und hält fest, wann der Anruf endete. Mit dieser Zahl rechnet das Budget.
Was der Wächter nicht sehen kann
Es gibt eine schmale Klasse von Client-Anfragen, die genau die Ereignisse erzeugt, die auch ein legitimer Gesprächszug erzeugt. Nichts, was das Sideband sieht, unterscheidet sich, also kann keine Regel auf dem Sideband sie erkennen.
Genauer beschreibe ich das nicht, solange die App im Test ist und jede Minute bezahlt. Für das Design zählt, was trotzdem hält, wenn der Wächter blind ist:
- Der Anruf endet beim Zeitlimit. Der Wächter legt nach 30 Minuten auf, egal was darin passiert ist.
- Das Budget liegt beim Server. Jede Minute zählt nach der Uhr des Servers gegen das Tages- und Monatskontingent.
- Ein Anruf pro Nutzer. Ein neuer Anruf sperrt die Nutzerzeile und legt einen offenen Anruf zuerst auf, damit parallele Anrufe nicht jeder das ganze Restbudget verbrauchen.
- Probekonten teilen einen Tagestopf. Jeder kann ohne Anmeldung ein Konto anlegen, Limits pro Konto wären also wertlos. Alle Probekonten zehren von einem gemeinsamen Tagestopf an Minuten; der ist die Obergrenze dessen, was Probezeit pro Tag kostet, egal wie viele Konten jemand per Skript anlegt. Kontoanlage ist außerdem pro IP gedrosselt (3 pro Stunde, 10 pro Tag), und hinter nginx vertraut die Drossel nur dem letzten Proxy-Hop in
X-Forwarded-For. - Das OpenAI-Projekt hat ein Ausgabenlimit. Das letzte Netz, und eines, das ich hoffentlich nie berühre.
Der Wächter stoppt den billigen Missbrauch sofort. Das Budget stoppt den teuren Missbrauch irgendwann. Keins von beiden allein würde reichen.
Wenn der Wächter stirbt
Der Wächter ist ein Thread im Webprozess. Ein Deploy startet diesen Prozess neu, und jeder Wächter stirbt mit, während sein Anruf vielleicht noch läuft.
Deshalb tut der Entrypoint des Containers Folgendes, bevor er eine einzige Anfrage bedient:
python manage.py migrate --noinput
python manage.py createcachetable
python manage.py sweep_calls --startup   # hang up every call whose guard ended with the old process
exec gunicorn falar.wsgi ...
Und ein eigener Aufräum-Container führt denselben Befehl jede Minute in einer Schleife aus, für Anrufe, die über den Punkt hinaus sind, an dem ihr Wächter aufgelegt hätte: der Fall, dass ein Worker ohne Deploy stirbt. Ein verwaister Anruf wird bis zu dem Zeitpunkt abgerechnet, an dem der Wächter ihn beendet hätte, nie länger, denn der Budget-Code deckelt eine offene Session bei der maximalen Anruflänge plus Kulanz.
Auch das Modell ist eine nicht vertrauenswürdige Eingabe
Nach jedem Wortwechsel schickt die App den Text des Gesagten an das Backend, und ein kleines Textmodell sucht darin Fehler und neue Vokabeln. Dessen Ausgabe landet in der Datenbank, also wird sie wie Nutzereingabe behandelt:
- ein striktes JSON-Schema für die Antwort, damit die API die Form durchsetzt und nicht die Hoffnung
- IDs von Wiederholungskarten, die das Modell zurückgibt, werden gegen die abgeglichen, die es bekommen hat; erfundene IDs werden ignoriert
store=Falsebei der Anfrage und einsafety_identifier, der ein HMAC der Nutzer-ID ist, damit OpenAI Missbrauch pro Nutzer erkennen kann, ohne zu erfahren, wer es ist- der Wortwechsel selbst wird nicht gespeichert, nur die herausgezogenen Fehler (die falsche Form, die richtige, eine Erklärung) und neue Wörter
Anmeldung, und der SHA-1, der richtig und trotzdem falsch war
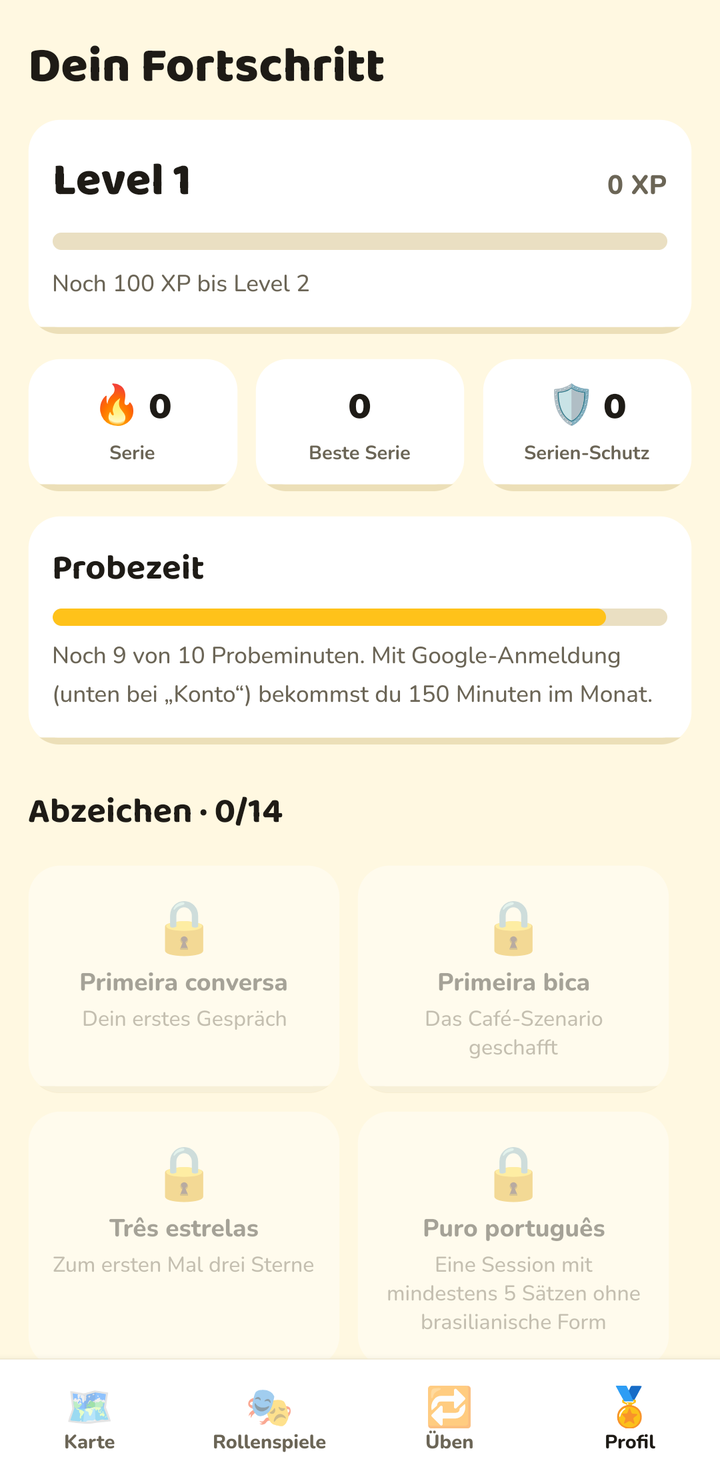
Konten starten anonym: ein Gerätekonto mit zehn Probeminuten, sein Token im verschlüsselten Speicher des Handys. Um den Fortschritt über Geräte hinweg zu behalten, meldest du dich mit Google an, über ein Google-Cloud-Projekt mit zwei OAuth-Clients: einem Web-Client, gegen dessen ID das Backend Tokens prüft, und einem Android-Client, an dem Google die App erkennt.
Die Prüfung im Backend ist die übliche, und der übliche Fehler ist, einen Teil davon wegzulassen. verify_oauth2_token prüft Signatur, Ablauf und dass die Audience meine Web-Client-ID ist; der Issuer wird ausdrücklich geprüft; eine E-Mail wird nur übernommen, wenn Google sie als verifiziert markiert. Tokens für mein Backend werden nur gehasht gespeichert und verfallen nach 180 Tagen ohne Nutzung.
Was schiefging, war kein Code. Die Anmeldung funktionierte im Entwicklungs-Build und scheiterte still im ersten Build aus dem Store. Im Android-OAuth-Client stand der SHA-1 meines Upload-Schlüssels. Google Play signiert jede App mit einem eigenen App-Signatur-Schlüssel neu, und dieses Zertifikat legt das Gerät vor. Der Fix war ein Fingerabdruck in der Cloud-Konsole. Die Lehre: Die App zeigte gar nichts an, als Google ablehnte, und das sah genauso aus, als hätte der Nutzer abgebrochen. Das nächste Update macht diesen Fehler sichtbar.
Auslieferung
Das Backend läuft in Docker Compose auf einem kleinen Hetzner-Server hinter nginx (HSTS, kein Versions-Banner, der Admin hinter einem zweiten Passwort und mit eigener Drossel). Das Image ist mehrstufig, läuft mit einem numerischen Nutzer ohne Root-Rechte und wurde nach Trivy-Funden neu gebaut. Deploys laufen nach grüner CI auf dem Hauptzweig, und der SSH-Schlüssel der Pipeline darf auf dem Server genau ein Skript ausführen (Forced Command mit restrict); der Server holt den Commit mit einem Nur-Lese-Deploy-Key. Die App bekommt Over-the-Air-Updates nach dem Merge und Store-Releases per Tag.
Unter den 122 Backend-Tests sind Budget, Anruf-Broker und Wächter, der Wächter gegen ein nachgebautes Sideband: geänderte Anweisungen, jede Session-Änderung, von der App geschriebene Nachrichten, von der App bestellte Antworten und ein Sideband, das ausfällt.
Bekannte Lücken
- Der blinde Fleck oben. Begrenzt durch Zeit, Budget und Ausgabenlimit, nicht geschlossen.
- Wächter leben in Web-Workern. Das Aufräumen fängt ihren Tod ab, aber ein eigener Prozess pro Anruf wäre sauberer, und den will ich, bevor viele Anrufe gleichzeitig laufen.
- Eine Woche an Zahlen. Alles hier stammt aus Entwicklung, internem Test und einem Live-Test der Erkennungsfelder. Der geschlossene Test mit externen Testern hat noch nicht begonnen.
- Die Kosten sind ein eigener Beitrag. Eine Minute mit Ana kostet derzeit gemessen etwa 9,5 Cent, nach einer Senkung von etwa 14. Wie, und warum eine billigere Kette aus Spracherkennung, Textmodell und Sprachausgabe selbst zu einem Zehntel des Preises verworfen wurde, ist der nächste Artikel.
Rahmen
Falar ist mein eigenes Produkt, im internen Test bei Google Play mit bisher zwei Testern. Noch nutzt es kein zahlender Kunde; die Bezahlung ist die nächste Phase. Das Repository ist privat. Das Design steht hier, weil das Problem nicht auf Sprachenlernen beschränkt ist: Jede App, die einem Client eine Live-Verbindung zu einem bezahlten Modell gibt, ob Sprache oder nicht, muss beantworten, was dieser Client darauf sagen darf.